Attention is all you need: La tecnología de dio vida a ChatGPT
El mecanismo de atención revolucionó la IA, se paso de resolver la ambigüedad del lenguaje con embeddings dinámicos y matrices Q, K, V, hasta permitir el procesamiento masivo en paralelo que hizo posible el nacimiento de ChatGPT.
El procesamiento del lenguaje natural (NLP)
El procesamiento del lenguaje natural, o NLP por sus siglas en inglés, es la discplina dentro de la inteligencia artificial dedicada a enseñar a las computadoras a comprender, interpretar y manipular el lenguaje humano.
Históricamente, las máquinas operaban estrictamente bajo lenguajes de programación estructurados; el NLP se puede entender como el puente que les permite procesar el mundo de una manera similar en la que lo hacen los humanos. En particular, las redes neuronales y el aprendizaje profundo han impulsado avances sustanciales al permitir modelar representaciones vectoriales densas, capturando el contexto y la semántica subyacente del lenguaje humano.
Sin embargo, las redes neuronales no entienden texto puro, solo números. Antes de procesar cualquier frase, se realiza un proceso llamado tokenización: el texto se divide en fragmentos llamados tokens, que pueden ser palabras enteras, partes de palabras, o letras. Cada token se transforma en un vector de números procesable por un algoritmo computacional.
El estado del arte antes del 2017
Previo al 2017, el estado del arte en el NLP dependía de arquitecturas diseñadas para procesar la información de manera estrictamente secuencial. El estándar eran las redes neuronales recurrentes (RNNs) y sus variantes, como las redes long short-term memory (LSTM). Estas arquitecturas ingieren texto token por token, típicamente de izquierda a derecha, manteniendo un "estado oculto" (hidden state), una especie de memoria a corto plazo que se actualiza con cada nueva palabra, combinando la entrada actual con el contexto de las palabras anteriores.
El problema crítico de las RNNs es que, en textos largos, esta memoria secuencial se diluye: al llegar al final de un parrafo, la red "olvida" el contexto incial debido a una limitación matemática en su entrenamiento conocida como el desvancimiento del gradiente. Además, al depender del token anterior para leer el sugiente, la paralelización de estas redes resulta difícil, haciendo su escalabilidad limitada.
En paralelo, se adaptaron arquitecturas de visión computacional, como las redes neuronales convolucionales (CNNs) unidimensionales aplicadas al texto. Las CNNs operan como una ventana deslizante que lee bloques de tokens simultáneamente. En esencia, eran capaces de resolver el problema de la escalabilidad, ya que permitían procesar datos en paralelo, y eran excelentes detectando patrones locales, como en fraes cortas. Sin embargo, las CNNs fracasan al intentar capturar dependencias a larga distancia: carecen de una visión global: para relacionar una palabra al inicio de la página con una al final, es necesario apilar una gran cantidad de capas convolucionales.
Tabla comparativa RNNs vs CNNs:
| Característica | RNNs | CNNs |
|---|---|---|
| Procesamiento | Secuencial | Paralelo |
| Contexto | Global (con amnesia) | Local (limitado al filtro) |
| Velocidad | Lenta | Rápida |
| Relaciones distantes | Difíciles (gradiente y contexto) | Requieren apilar demasiadas capas |
En concreto, existía un límite estructural: se requería una arquitectura capaz de procesar datos masivos en paralelo, y a la vez capaz de modelar directamente las dependencias entre cualquier par de palabras en una secuencia.
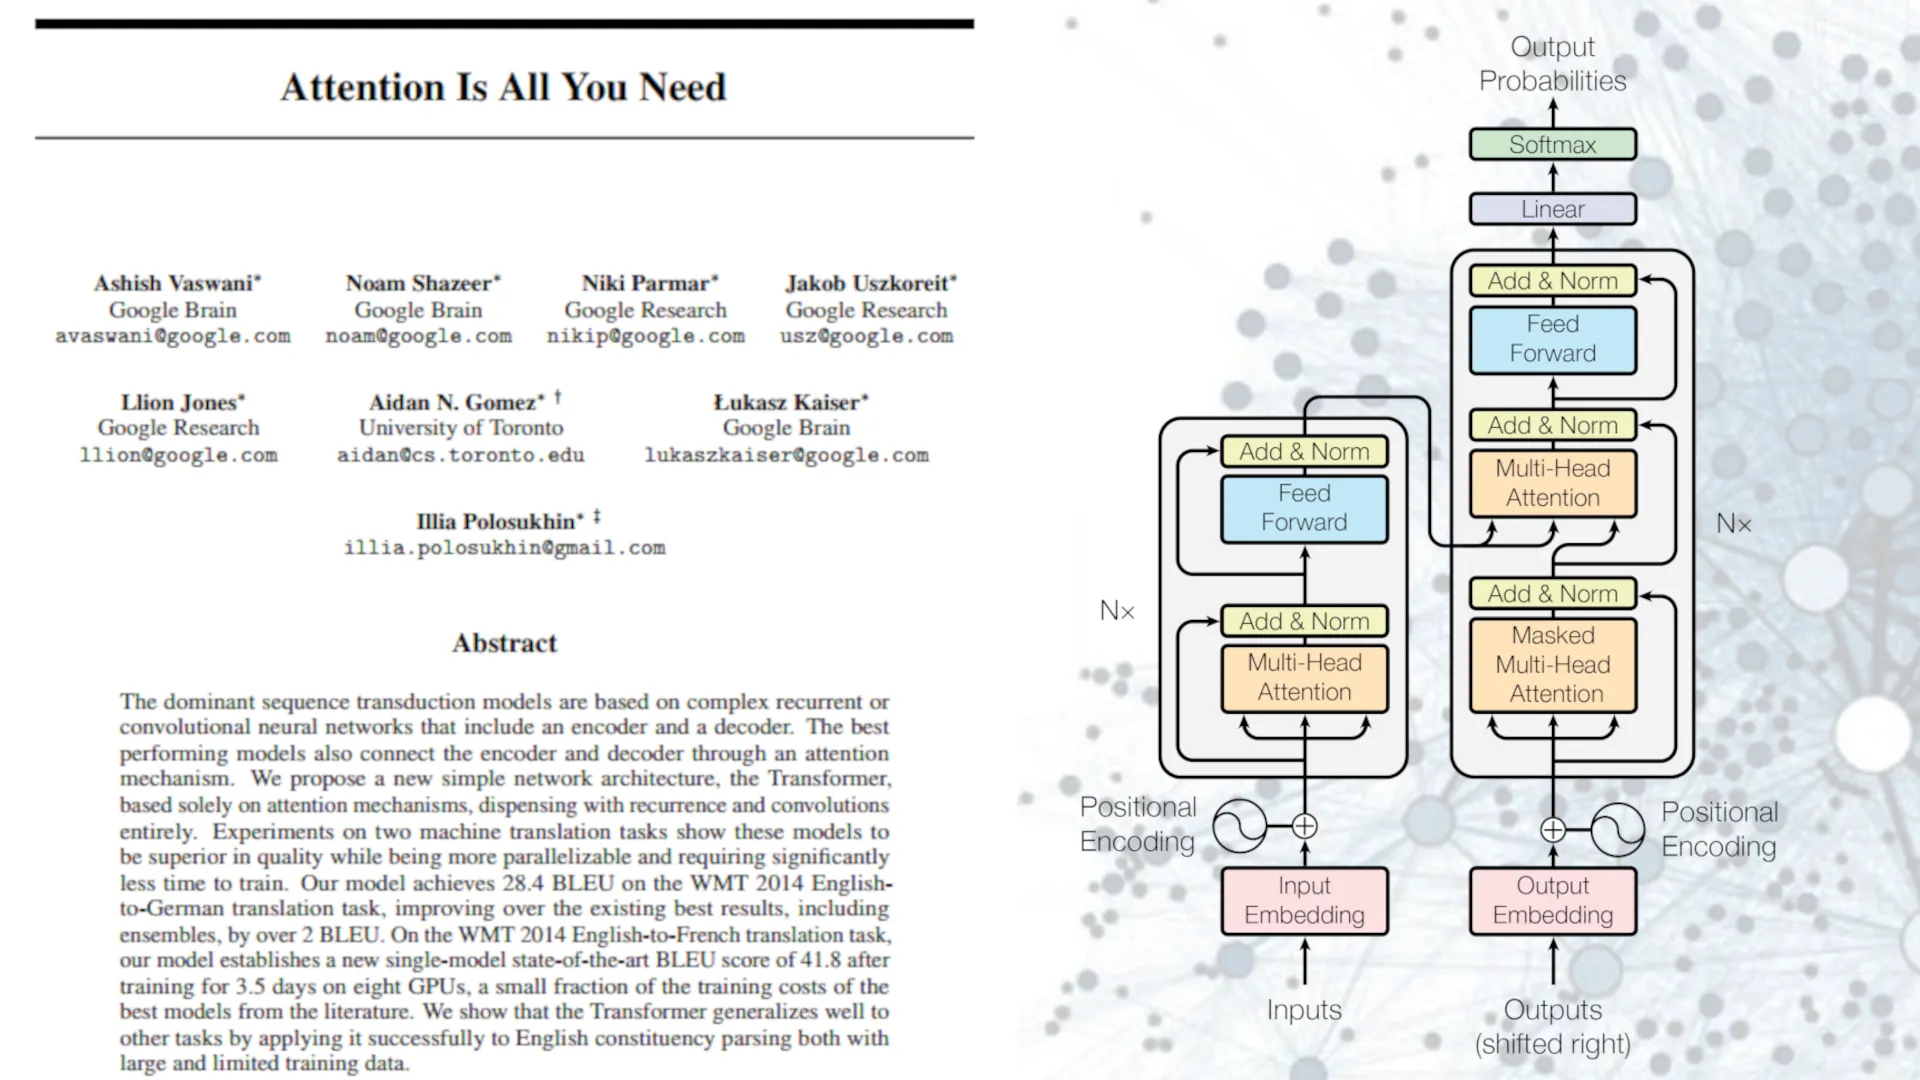
En 2017, Vaswani et al., ingenieros y científicos de Google, introducen la arquitectura Transformer en su paper fundacional "Attention is All you Need" [1], lo que marca una nueva era del NLP.
Tokenización, embeddings y el problema del contexto
Lo primero es entender cómo una red neuronal "lee". En realidad no lee letras, sino que divide el texto en piezas pequeñas llamadas tokens. Un token es un fragmento de texto que la máquina trata como una unidad; para nuestra explicación imaginemos estos tokes como palabras, aunque en los modelos reales a veces son sílabas o trozos de palabras.
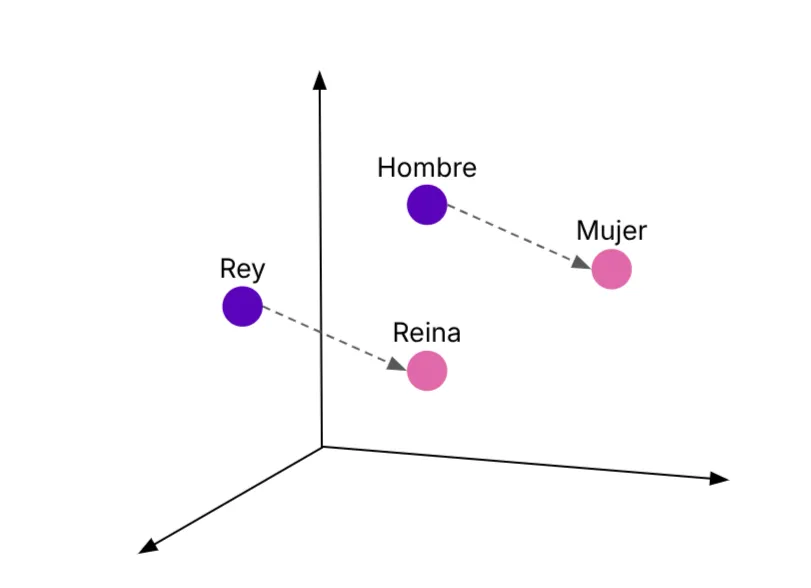
Cada token se convierte después en un embedding: una lista de números (vector) que actúa como las coordenadas de esa palabra dentro de un gigantesco "mapa de significados". En ese mapa, las palabras parecidas viven en zonas cercanas, y lo interesante es que las direcciones también cargan sentido: si desde la posición de la palabra hombre caminas hacia la palabra mujer y luego repites exactamente el mismo desplazamiento partiendo de rey, llegas a reina. El mapa sabe, por así decirlo, qué relación une a cada par de palabras.
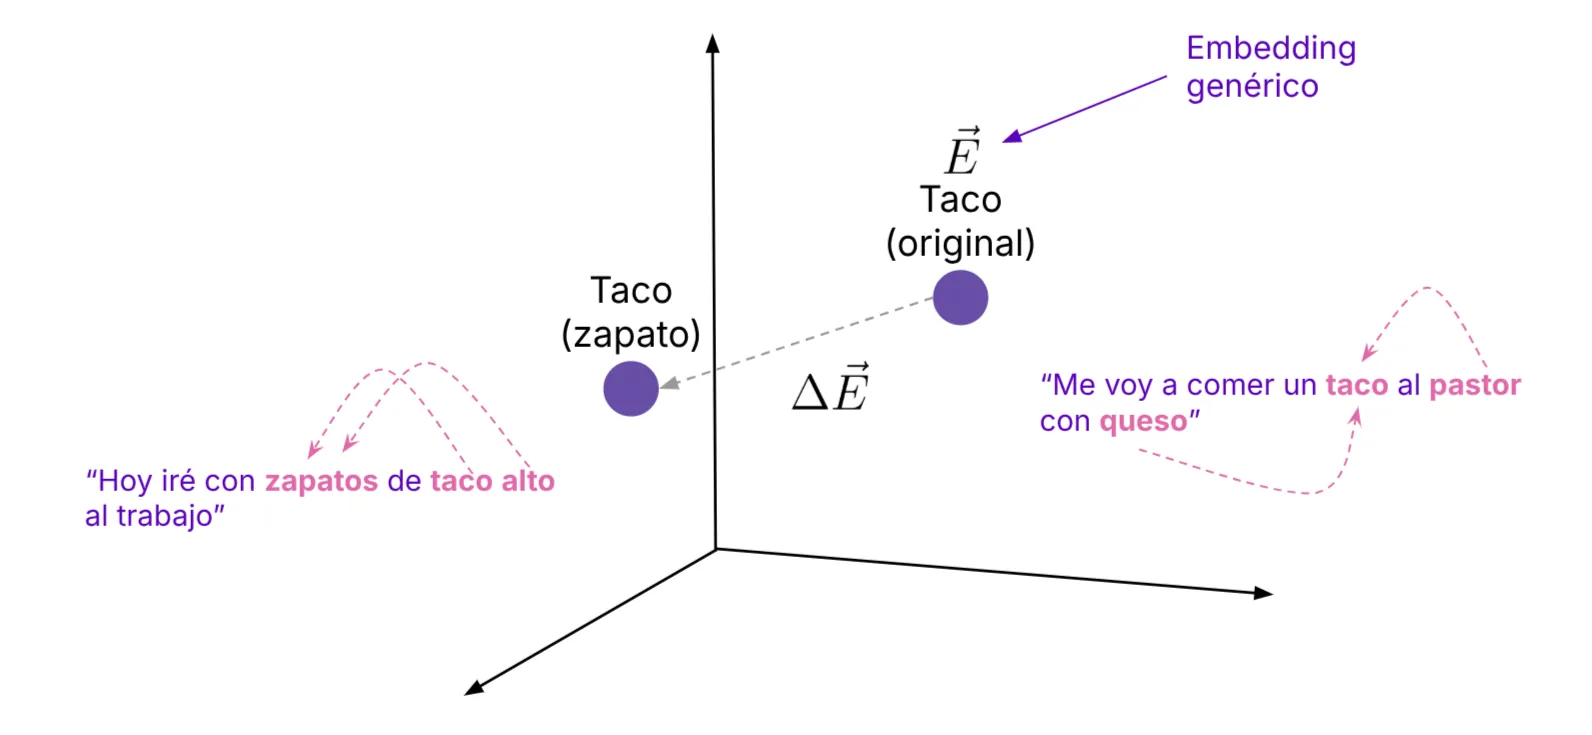
Sin embargo, este mapa tiene una falla que revela el verdadero problema que venía a resolver el Transformer. Los embeddings clásicos son fijos. Un ejemplo de porque esto es un problema es la palabra taco, esta tiene un solo punto en el mapa, sin importar si en la frase hablamos de un atasco, de un zapato, de una comida o de un taco de billar. Los cuatro sentidos comparten exactamente las mismas coordenadas.
Piénsalo con esta frase: "Como estaba atrapada en el taco de la autopista, se sacó los zapatos de taco para descansar sus pies". Un humano puede resolver las ambigüedades en una fracción de segundo, porque conocemos el contexto. El modelo, en cambio, veía dos veces el mismo punto del mapa, idéntico en la palabra atrapada y en la palabra zapatos. El embedding, tal como se generaba, no conocía el contexto, por lo que no podía diferenciarlas.
Por lo tanto, la gran idea del Transformer es que el embedding de una palabra no debía quedar congelado. Cada palabra parte de su posición genérica, pero a medida que la red procesa la frase, su vector se desplaza progresivamente hacia la zona del mapa que corresponde a ese contexto: el taco de la autopista migra hacia atasco; el taco de los zapatos, hacia calzado. Ya no codifica solo una palabra, sino su contenido semántico.
¿Y quién decide cuánto desplazar cada punto y hacia dónde? Eso es, precisamente, el mecanismo de atención [2]: el modelo calcula un "empujón" (que llamaremos ) para cada palabra, sumando influencias de las palabras que la rodean, con más peso para las relevantes y menos para las irrelevantes.
El mecanismo de atención (single head → multi head)
:::info Hasta ahora hemos mentido un poco: El vector que entra al Transformer no es solo el embedding semántico; también codifica la posición de la palabra en la frase. Eso lo explicaremos en el capítulo de arquitectura. Además, lo que sigue no es exactamente lo que hace un modelo ya entrenado, cuyos cálculos internos son una caja negra difícil de interpretar. Es una reconstrucción paso a paso para entender qué hace cada pieza y con qué propósito. :::
Empecemos viendo la fórmula completa de la atención, tal como aparece en el paper original [1], y luego construyámosla pieza por pieza [3]:
Para la siguiente explicación pensemos en la frase "El banco de madera estaba roto". La usaremos como hilo conductor: cada palabra formulará su pregunta (Query), ofrecerá su respuesta (Key), y al final de la sección armaremos el cálculo completo paso a paso.
Query: la pregunta que se hace cada palabra
Imagina que cada palabra, al leer la frase, se pregunta: "¿hay descriptores para mí? ¿alguien aquí me describe o me complementa?", y que esa pregunta se codifica en un vector propio, llamado Query (del inglés: consulta). ¿Y cómo se genera? Multiplicando el embedding por una tabla de números ajustables llamada matriz de pesos, notada . Si el embedding de "banco" es , entonces .
La Query es un vector más pequeño que el embedding (de dimensión , menor que la del embedding original). Esa reducción es deliberada: obliga a cada palabra a condensar su pregunta en pocas coordenadas, sin arrastrar todo su significado.
Key: la respuesta que ofrece cada palabra
En consecuencia, si cada palabra hace una pregunta, cada palabra también debe poder responder. Para eso existe otra matriz de pesos, (de key, llave): . La Key funciona como el cartel en el estante de una biblioteca: no es el contenido completo del libro, sino la que dice "yo puedo aportarte esto". Cuando la Query de "banco" pregunta "¿hay descriptores para mí?", la Key de "madera" contesta en el fondo: "sí: material, madera".
El producto punto Q, K: medir el alineamiento
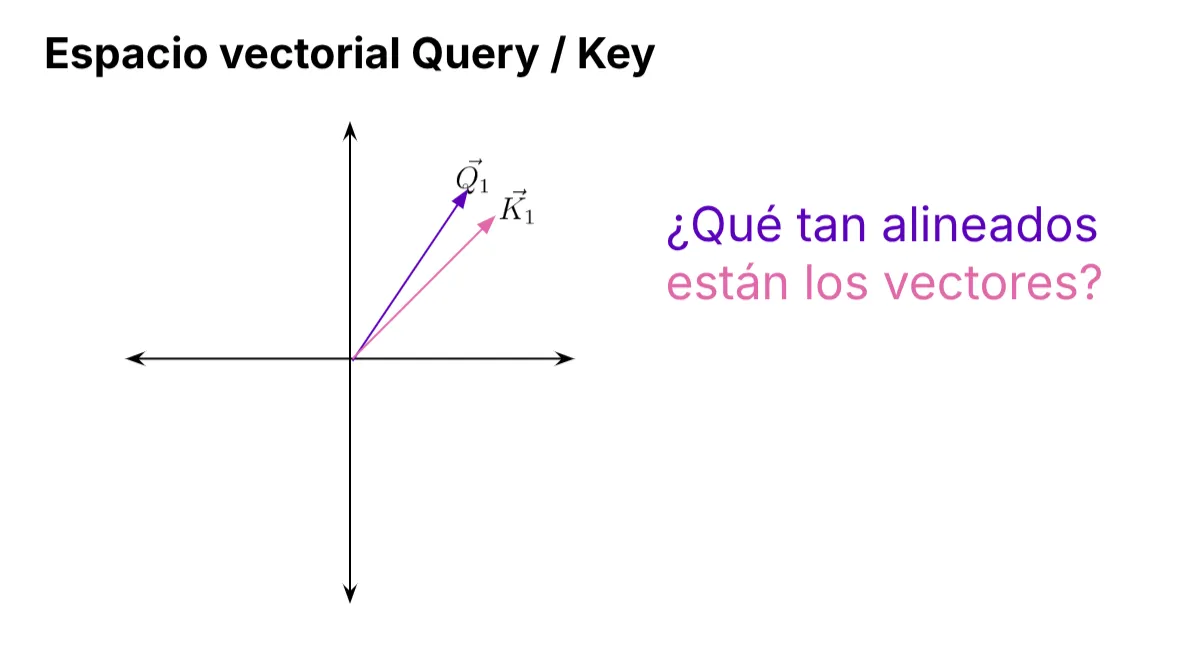
Ahora falta comparar preguntas con respuestas, y aquí entra el producto punto, una operación que mide qué tan "alineadas" están dos flechas en el espacio: si apuntan en la misma dirección, el resultado es un número grande; si son perpendiculares, es cero; si apuntan en direcciones opuestas, es negativo. Por lo tanto, calcular produce una tabla de coincidencias: la celda de la fila i y columna j indica cuánto responde la Key de la palabra j a la pregunta de la palabra i. Números grandes significan correspondencia fuerte: esa query se responde con esa key.
Softmax y escalado
Un número como 7 o 1 todavía no es una instrucción útil: necesitamos saber cuánta atención dar a cada palabra, en porcentaje. El softmax es la función que convierte cualquier lista de números en una distribución de probabilidades que suma 1, respetando el orden: quien tenía puntaje alto recibe un porcentaje mayor. Aplicado a cada fila de nuestra tabla de coincidencias, obtenemos algo muy interpretable: "la palabra gato debe mirar un a negro, un a sí misma y solo un a sillón".
¿Y por qué dividimos por antes del softmax? Por estabilidad numérica. En espacios de muchas dimensiones, los productos punto tienden a crecer; y con números muy grandes el softmax se comporta como un "todo o nada": castiga con porcentajes casi nulos a las opciones secundarias, y el entrenamiento se atasca, porque esas señales casi nulas no dan información para aprender. Dividir por la raíz de es, en consecuencia, una "perilla de volumen": mantiene los puntajes en un rango cómodo donde todas las opciones conservan algo de señal.
El attention pattern y el masking
El resultado de , una vez pasado por softmax, se llama attention pattern: el mapa de quién se relaciona con quién dentro de la frase.
Y aquí aparece el masking (enmascaramiento). El objetivo principal de un Transformer es predecir la siguiente palabra, y conviene entrenarlo para que lo haga desde cualquier punto de la frase: "El" → ¿?, "El barco" → ¿?, "El barco de" → ¿?, y así sucesivamente. Así, una sola frase genera muchos ejemplos de entrenamiento a la vez [4]. Pero hay un riesgo: que el modelo "haga trampa" mirando el futuro. Para impedirlo, se llenan con las celdas que apuntan a palabras posteriores (el triángulo superior de la matriz) antes de aplicar el softmax; convertido en probabilidad es exactamente cero. Es como tapar con una cartulina el resto del renglón mientras lees, para no adelantarte a la respuesta.
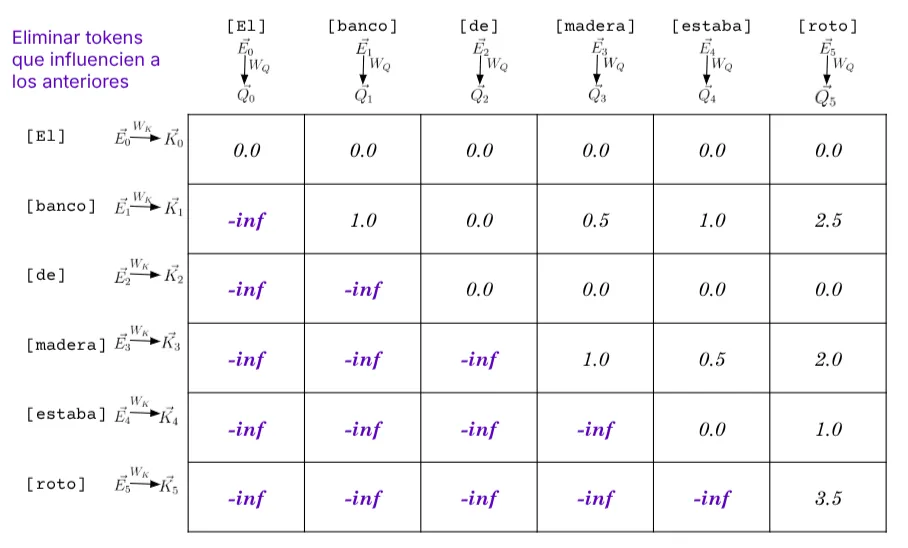
Un dato relevante hoy: la matriz de atención es de , es decir, crece cuadráticamente con la cantidad de tokens. Con 1 000 tokens hay que calcular un millón de relaciones; con 10 000, cien millones. Por eso los textos largos son caros de procesar y por eso las aplicaciones de chat ponen límites de contexto.
Value: el material con el que se construye el significado
Hasta aquí solo sabemos cómo se relacionan las palabras; falta el paso que realmente mueve el embedding original para que adquiera las cualidades que le corresponden: gato + negro → gato negro. Para eso existe una tercera matriz, : . El Value (valor) es el "aporte" de cada palabra: lo que esa palabra puede añadirle al significado de otra. La de "negro" aporta "color: negro".
Finalmente, tomamos la fila del attention pattern correspondiente a la palabra (sus porcentajes de atención) y la multiplicamos por los , sumando todo. El resultado es el desplazamiento : el empujón que traslada el embedding original hacia su significado contextual. Por ejemplo, si "gato" mira un a "negro", su estará compuesto en un por el aporte de "negro". Notar: el nuevo embedding se forma como , es decir, sumando sobre el original; esa suma es, de hecho, la conexión residual que volverá a aparecer en la arquitectura.
Importante: las matrices , y no son magia ni vienen de fábrica. Son los parámetros de la red, los números que el Transformer debe encontrar durante el entrenamiento. Entrenar un modelo es, en esencia, ajustar estas tablas hasta que las preguntas, respuestas y aportes que producen sean útiles.
Un ejemplo paso a paso: "El gato negro dormía en el sillón viejo"
Veamos todo junto con la frase "El gato negro dormía en el sillón viejo": tiene dos pares sustantivo–adjetivo ("gato"–"negro" y "sillón"–"viejo") y un verbo que los une. Usaremos vectores de 2 dimensiones con números inventados, pero que sirven para el ejemplo (en un modelo real son cientos de dimensiones y valores aprendidos, pero el razonamiento es idéntico.)
Dos aclaraciones: omitimos los conectores "El", "en" y "el" para que las tablas quepan en la página; y mostraremos el patrón completo, sin máscara (tal como lo calcularía un encoder) - en un decoder, las celdas del "futuro" estarían tapadas con , como vimos antes.
Paso 1 - Queries y Keys (en la práctica, salidas de y ):
| Palabra | Q (pregunta) | K (oferta) |
|---|---|---|
| gato | "¿quién me describe?" | "sujeto principal" |
| negro | "¿a quién describo?" | "yo describo" |
| dormía | "¿quién es mi sujeto?" | "aporto acción" |
| sillón | "¿quién me describe?" | "objeto principal" |
| viejo | "¿a quién describo?" | "yo describo" |
Paso 2 - Puntajes , divididos por :
| (pregunta ↓ / oferta →) | gato | negro | dormía | sillón | viejo |
|---|---|---|---|---|---|
| gato | |||||
| negro | |||||
| dormía | |||||
| sillón | |||||
| viejo |
Paso 3 - Softmax por filas (los porcentajes de atención):
| (pregunta ↓ / oferta →) | gato | negro | dormía | sillón | viejo |
|---|---|---|---|---|---|
| gato | |||||
| negro | |||||
| dormía | |||||
| sillón | |||||
| viejo |
Viendo cada fila:
- La de "gato": a "negro" (su descripción), a sí misma y un toque a lo demás.
- La de "negro": mira sobre todo a "gato" (), porque un adjetivo necesita saber a quién describe.
- La de "dormía": se concentra en su sujeto, "gato" (), que es exactamente lo que un verbo necesita saber.
Las filas de "sillón" y "viejo" repiten, en espejo, la historia de "gato" y "negro": el mueble y su adjetivo se miran entre sí ( y ). Y fíjate en el efecto del escalado: sin dividir por , "negro" se llevaría cerca de de la atención de "gato" en vez de - el "todo o nada" que queremos evitar, suavizado.
Paso 4 - Los Values y el desplazamiento. Intentemos los aportes de cada palabra:
| Palabra | V (aporte) |
|---|---|
| gato | "nada nuevo para sí misma" |
| negro | "color: negro" |
| dormía | "matiz de acción" |
| sillón | "otra cosa: no aporta al gato" |
| viejo | "matiz: viejo" |
El desplazamiento de "gato" es la suma ponderada de todos los aportes, usando su fila de atención:
Es decir: el empujón está dominado por "negro", con un toque del verbo y un matiz mínimo de "viejo". "Gato" se desplaza, por lo tanto, hacia su significado completo en esta frase: gato negro que dormía. Las demás filas repiten el mismo cálculo en paralelo, y cada palabra termina con su propio embedding contextualizado (). Apilando capas, el efecto se refina: la palabra ajustada por la capa 1 vuelve a entrar, ahora mejor informada, a una nueva ronda de atención.
Matiz sobre el paper original
En el paper [1], la matriz de atención no tiene los mismos tokens en vertical y en horizontal: la tarea era traducción, así que en un eje van los tokens de español y en el otro los de inglés. El decoder pregunta contra las salidas del encoder; a ese cruce entre dos secuencias distintas se le llama cross-attention (atención cruzada). Lo que construimos arriba - una palabra mirando a las palabras de su propia frase - es el caso particular llamado self-attention (auto-atención), que en el Transformer de 2017 resulta ser la protagonista.
Multi-Head Attention
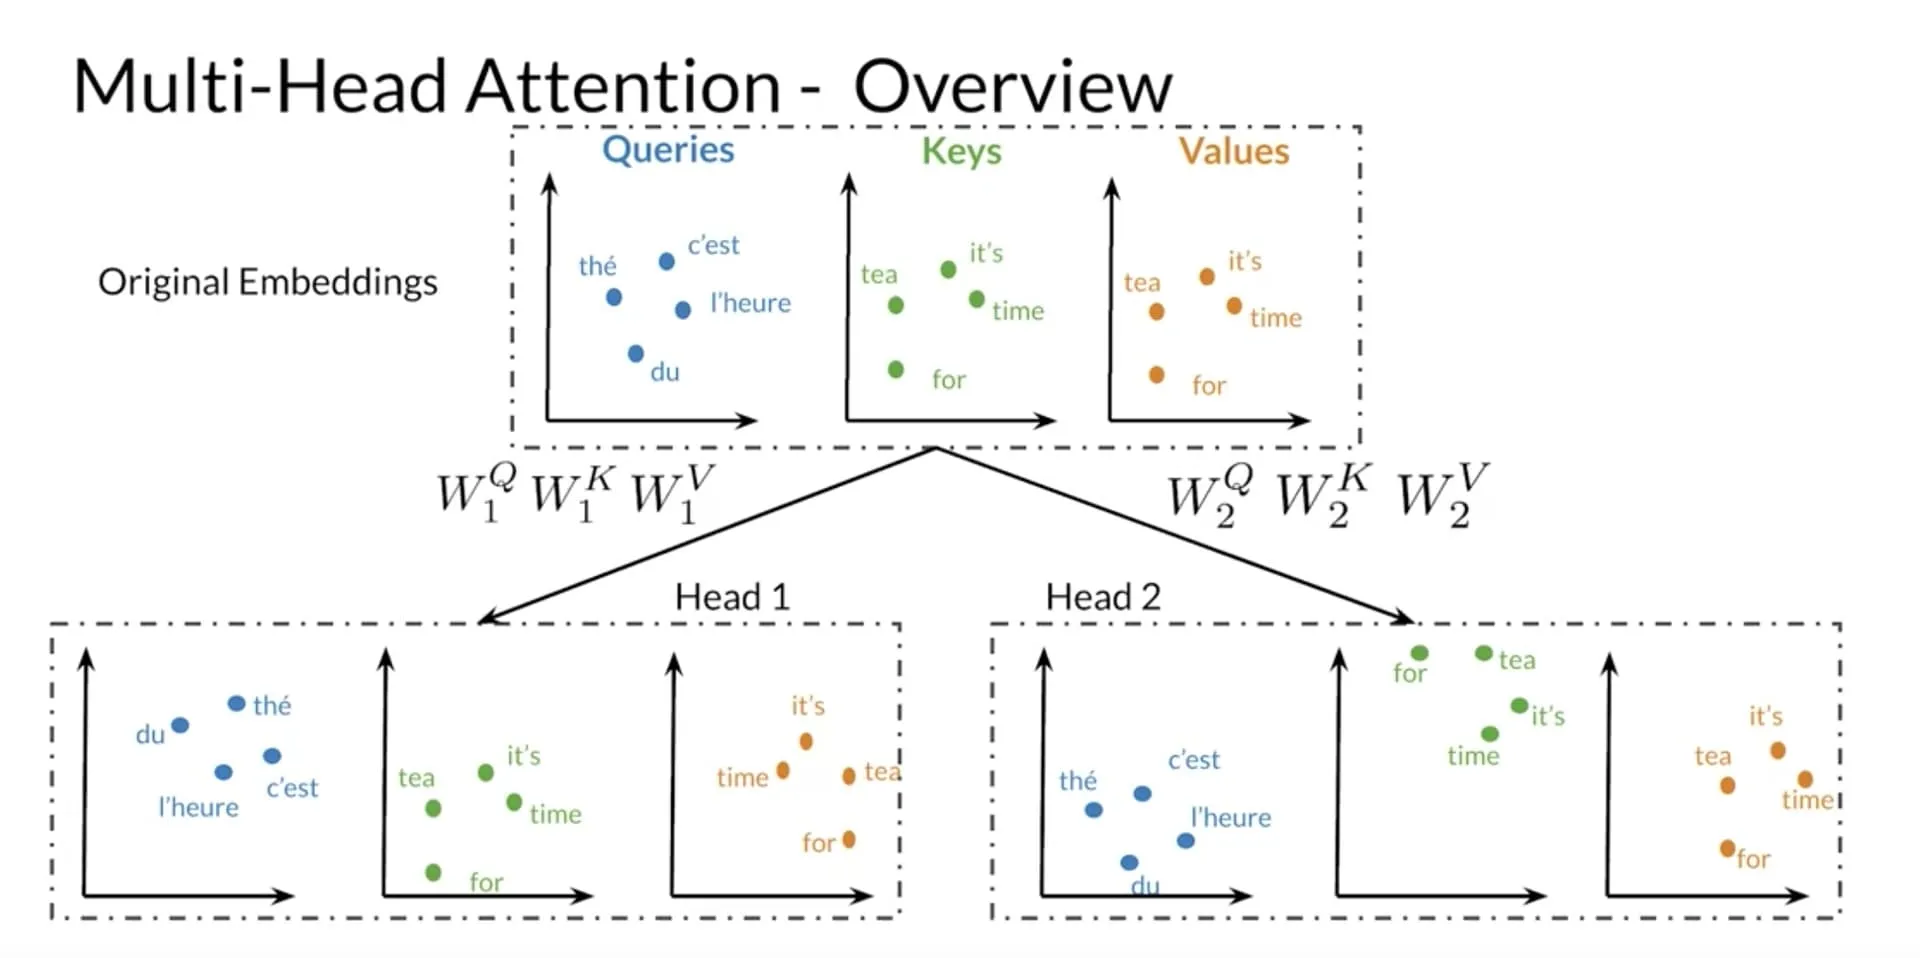
En un modelo entrenado, cada trío , , captura una forma de interpretar el texto, y lo que realmente aprenden es mucho más complicado de describir - una caja negra. La solución del Transformer no fue adivinar esa complejidad, sino repetir el mecanismo en paralelo: esto es la multi-head attention (atención de múltiples cabezas). Cada cabeza tiene su propio trío de matrices, propone su propio , y al final todas las propuestas se concatenan y se proyectan (con una matriz final ) para sumarse al embedding original.
La fórmula completa, ya traducida a palabras: cada cabeza i hace su propia atención con sus matrices propias, y la salida final es la concatenación de todas las cabezas pasada por [1]:
Arquitectura general del Transformer
Encoder y decoder
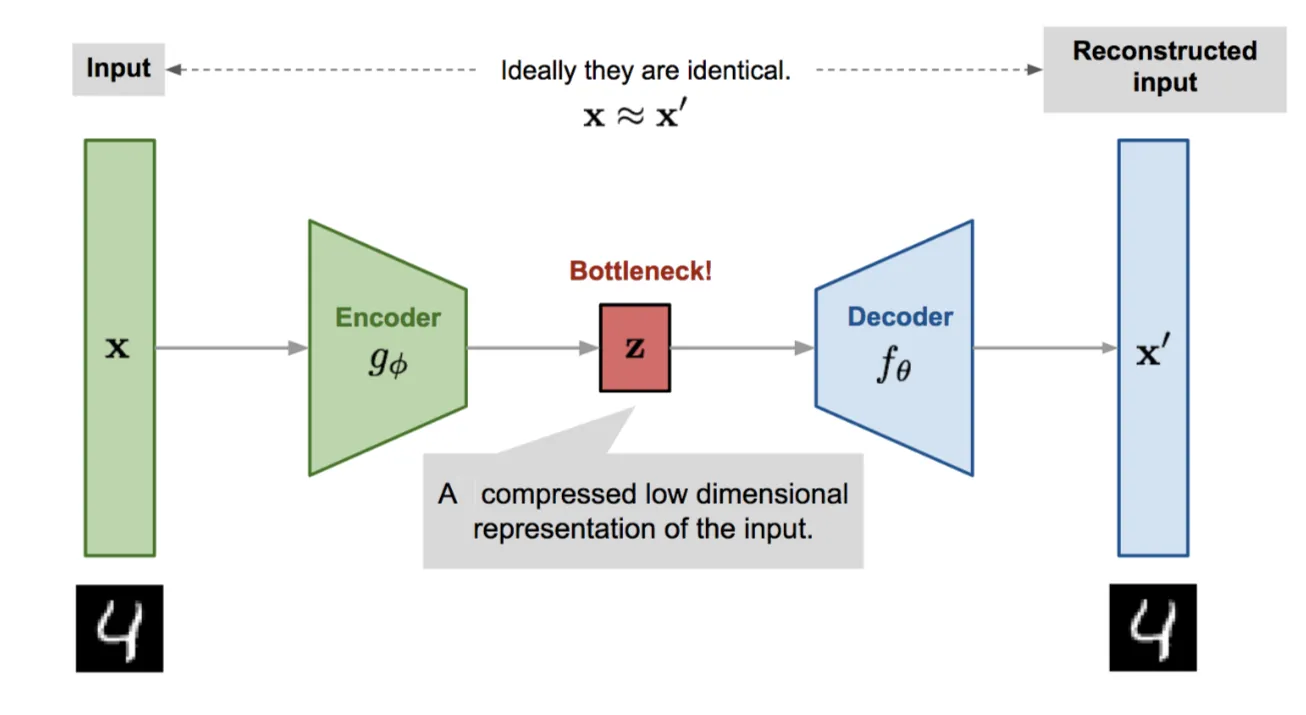
Un sistema encoder–decoder pasa de una entrada a un espacio latente más pequeño - una representación interna comprimida - y de ahí a una salida, buscando que la relación entre entrada y salida sea lo más fiel posible [5]. Ese punto intermedio angosto se conoce como bottleneck (cuello de botella), y su función es forzar la abstracción: si solo puedes "guardar" la esencia, tienes que descubrir cuál es la esencia.
La estructura completa
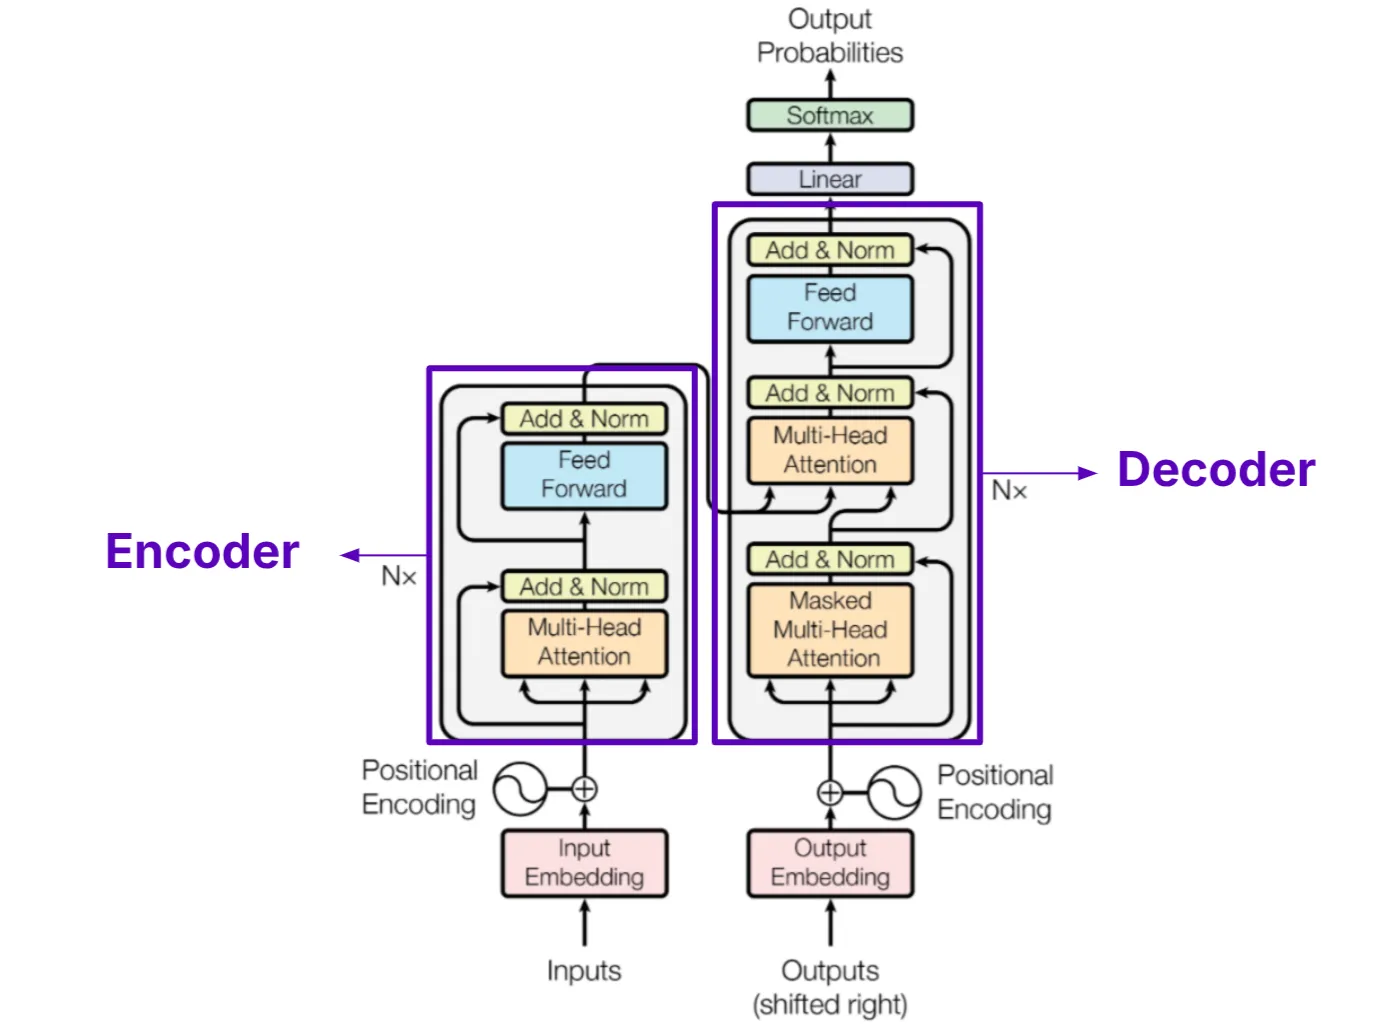
El Transformer apila N capas idénticas en dos torres [1], [4]:
- Encoder: cada capa contiene un bloque de Multi-Head Attention (las palabras de la frase se miran entre sí) y un bloque Feed Forward - una pequeña red neuronal que se aplica a cada palabra individualmente. Después de cada bloque hay un Add & Norm: se recupera una copia de lo que entraba al bloque (conexión residual, la suma que ya vimos) y se normaliza la escala de los números para que nada explote ni se apague.
- Decoder: cada capa contiene primero una Masked Multi-Head Attention (se mira a lo que ya ha escrito, sin poder ver el futuro), luego una Cross-Attention cuyas Keys y Values vienen del encoder y por último su Feed Forward y Add & Norm.
- Salida: una capa Linear que produce puntajes crudos (los logits, todavía sin normalizar) y un softmax final que los convierte en probabilidades sobre todo el vocabulario.
Experimentación
El artículo [1] evaluó la arquitectura transformer en la tarea de traducción, en particular:
-
Datos utilizados: se utilizaron benchmarks internacionales WMT 2014, estándar de la época para evaluar modelos de traducción.
-
Traducción inglés a alemán: ~4.5 millones de pares de oraciones.
-
Traducción inglés a francés: ~36 millones de pares de oraciones.
-
-
¿Contra quién compitieron?: Se compararon con el estado del arte de la época: redes recurrentes (RNNs), LSTMs, GNMT de Google, ConvS2S, ByteNet y ensembles.
-
Métrica: se utilizó la métrica Bilingual Evaluation Understudy (BLEU), la cual mide cuánto se parece la traducción generada a la de los datos de referencia. Por ejemplo, dada la oración "The cat is sleeping on the sofa", y la tarea de traducción de inglés a español:
-
Se cuenta con una referencia humana: "El gato está durmiendo en el sofá".
-
Modelo A: "El gato está durmiendo en el sofá" → coincidencia amplia → BLEU alto.
-
Modelo B: "El felino duerme sobre el mueble" → significado correcto pero palabras distintas → BLEU medio.
-
Modelo C: "El perro está corriendo en el jardín" → significado incorrecto → BLEU muy bajo.
-
-
Además midieron cuánto tiempo se demoraron en entrenar los modelos.
-
La pregunta de investigación principal: ¿se puede utilizar una red basada únicamente en atención, y se traduce esto en un entrenamiento más corto?
Resultados
Los modelos Transformer superaron consistentemente el estado del arte en ambas tareas de traducción evaluadas [1], demostrando superioridad tanto en calidad como en eficiencia computacional:
-
Traducción Inglés-Alemán (EN-DE): El modelo Transformer (Big) estableció un nuevo estado del arte al alcanzar un puntaje BLEU de 28.4, superando a los mejores modelos y ensambles existentes por más de 2.0 puntos BLEU.
-
Traducción Inglés-Francés (EN-FR): El mismo modelo logró un puntaje BLEU de 41.8, superando nuevamente a todas las arquitecturas de la literatura anterior publicadas hasta ese momento.
-
Costo de entrenamiento (FLOPs/Tiempo): Las arquitecturas lograron los resultados anteriores con un costo computacional notablemente inferior. El modelo base del Transformer fue entrenado en solo 3.5 días utilizando 8 GPUs P100, requiriendo entre un décimo y un centésimo del total de operaciones de entrenamiento (FLOPs) que demandaban arquitecturas recurrentes (GNMT) o convolucionales (ByteNet).
¿Por qué fue mejor que el estado del arte?
El Transformer rindió efectivamente mejor que lo que existía en 2017, pero ¿por qué? El estado del arte eran las RNN (redes neuronales recurrentes): redes que leen el texto palabra por palabra, arrastrando y actualizando una memoria interna. Ese diseño, que parecía natural, escondía dos limitaciones serias:
- La paralelización: En una RNN, para computar la palabra necesitas primero el resultado de la palabra : hay una dependencia en cadena. Eso impide aprovechar eficientemente los computadores de la época - y de hoy -, en particular las GPUs: chips especializados en ejecutar miles de cálculos simples al mismo tiempo.
- Las dependencias de larga distancia: En un texto largo, palabras muy alejadas pueden depender entre sí: "El perro que vimos hace dos semanas … … … estaba cansado". Para saber qué estaba cansado, la información de "perro" debe sobrevivir el trayecto completo hasta "estaba cansado". Las RNN tienden a olvidar las palabras antiguas a medida que entra contenido nuevo: es el juego del teléfono descompuesto, donde el mensaje pasa de persona en persona y llega cada vez más distorsionado. El mecanismo de atención elimina el juego: cualquier palabra tiene acceso directo a cualquier otra, por lejana que esté.
Estas dos ventajas no solo permitieron entrenar más rápido: permitieron entrenar modelos cada vez más grandes. Esa capacidad de escalar es, precisamente, la que dio origen a BERT [6], a GPT y a todos los modelos modernos.
La situación actual
En los últimos tiempos, la arquitectura Transformer ha visto mejoras y variaciones en las siguientes áreas:
- Modelos de razonamiento: LLMs entrenados específicamente para razonar.
- Mejoras en eficiencia: Flash Attention, DeepSeek y otros han diseñado maneras de entrenar/utilizar modelos con menor costo.
- Harnesses: Aumentar las capacidades de los modelos a través de una infraestructura unificada, Claude, Codex y Pi siendo algunos exponentes notables.
- Aprendizaje por Refuerzo basado en Objetivos: Integración de algoritmos de optimización de políticas (como PPO) y métodos de alineación (RLHF o DPO), para maximizar funciones de recompensa estrictas en dominios de razonamiento formal y matemático.
En cualquier caso, la arquitectura Transformer ha resultado transformacional para el área, y sus repercuciones han llegado mucho más allá del procesamiento del lenguaje natural, estableciendo una arquitectura fundacional unificada para una diversidad de aplicaciones.
Por qué es importante
El mecanismo que acabas de recorrer no vive solo en un paper, se utiliza en tu corrector automático, en tu traductor, en tu buscador y en cada chat de soporte técnico. Entender la atención es entender, en consecuencia, qué pueden y qué no pueden hacer estos sistemas: no "leen" como un humano; reconstruyen significado estadísticamente, moviendo vectores en un mapa. Esa distinción es criterio práctico: saber cuándo confiar, cuándo verificar y por qué un modelo puede sonar seguro y aun así estar equivocado. Y también explica límites concretos de tu vida digital: los límites de contexto de las apps de IA existen porque la matriz de atención crece cuadráticamente - cada palabra extra cuesta cada vez más.
Si quieres profundizar
- The Illustrated Transformer (Jay Alammar) [7] - la explicación visual clásica, paso a paso.
- La serie de videos de 3Blue1Brown sobre Transformers y atención [8], [9] - visualizaciones excepcionales de todo lo descrito aquí.
- The Annotated Transformer (Harvard NLP) [10] o el video Let's build GPT from scratch de Andrej Karpathy [11] - para quienes quieran ver el mecanismo traducido a código, línea por línea.
Fuentes
[1] A. Vaswani, N. Shazeer, N. Parmar, J. Uszkoreit, L. Jones, A. N. Gomez, Ł. Kaiser, and I. Polosukhin, "Attention is all you need," in Advances in Neural Information Processing Systems (NeurIPS), vol. 30, 2017, pp. 5998–6008. [Online]. Available: https://arxiv.org/abs/1706.03762
[2] D. Bahdanau, K. Cho, and Y. Bengio, "Neural machine translation by jointly learning to align and translate," in Proc. 3rd Int. Conf. Learning Representations (ICLR), San Diego, CA, USA, 2015. [Online]. Available: https://arxiv.org/abs/1409.0473
[3] S. Cristina, "The attention mechanism from scratch," MachineLearningMastery.com, Jan. 6, 2023. Accessed: Sep. 30, 2026. [Online]. Available: https://machinelearningmastery.com/the-attention-mechanism-from-scratch/
[4] U. Jamil, "Attention is all you need (Transformer) - Model explanation (including math), inference and training," YouTube, May 28, 2023. [Online Video]. Available: https://www.youtube.com/watch?v=bCz4OMemCcA. Accessed: Sep. 30, 2026.
[5] L. Weng, "From autoencoder to beta-VAE," Lil'Log, Aug. 12, 2018. Accessed: Sep. 30, 2026. [Online]. Available: https://lilianweng.github.io/posts/2018-08-12-vae/
[6] J. Devlin, M.-W. Chang, K. Lee, and K. Toutanova, "BERT: Pre-training of deep bidirectional transformers for language understanding," in Proc. 2019 Conf. North American Chapter of the Association for Computational Linguistics: Human Language Technologies (NAACL-HLT), Minneapolis, MN, USA, 2019, pp. 4171–4186. [Online]. Available: https://arxiv.org/abs/1810.04805
[7] J. Alammar, "The illustrated transformer," Jun. 27, 2018. Accessed: Sep. 30, 2026. [Online]. Available: https://jalammar.github.io/illustrated-transformer/
[8] G. Sanderson (3Blue1Brown), "Transformers, the tech behind LLMs | Deep Learning Chapter 5," YouTube, Apr. 1, 2024. [Online Video]. Available: https://www.youtube.com/watch?v=wjZofJX0v4M. Accessed: Sep. 30, 2026.
[9] G. Sanderson (3Blue1Brown), "Attention in transformers, step-by-step | Deep Learning Chapter 6," YouTube, Apr. 7, 2024. [Online Video]. Available: https://www.youtube.com/watch?v=eMlx5fFNoYc. Accessed: Sep. 30, 2026.
[10] A. Huang, S. Subramanian, J. Sum, K. Almubarak, S. Biderman, and A. Rush, "The annotated transformer," Harvard NLP, 2022. Accessed: Sep. 30, 2026. [Online]. Available: https://nlp.seas.harvard.edu/annotated-transformer/
[11] A. Karpathy, "Let's build GPT: from scratch, in code, spelled out," YouTube, Jan. 17, 2023. [Online Video]. Available: https://www.youtube.com/watch?v=kCc8FmEb1nY. Accessed: Sep. 30, 2026.
Autores
Guillermo Oliva Orellana
Célula de Capacitación
Antonio Skorin García
Célula de Capacitación